Le mode dégradé n’est pas un écran de secours
Dans un bâtiment logistique, tertiaire ou industriel, une panne de supervision ne doit pas automatiquement arrêter la ventilation, le froid ou les équipements essentiels. La continuité repose sur l’architecture complète : régulation locale, automatismes, réseaux, alimentation, capteurs, actionneurs et organisation humaine. Un écran secondaire ne sert à rien si les automatismes n’ont pas de stratégie autonome ou si personne ne connaît les commandes disponibles sur le terrain.\n\nLe mode dégradé désigne un fonctionnement volontairement limité, mais sûr et maîtrisé. Il conserve les fonctions prioritaires, neutralise les optimisations non essentielles et maintient une visibilité suffisante pour l’exploitant. Sa conception commence donc par les usages et les conséquences, pas par le choix d’un produit.
Classer les fonctions selon leur criticité
Toutes les données n’ont pas la même importance. Une température de confort en bureau n’a pas le même enjeu qu’une alarme de chambre froide, une pression indispensable à un process ou une commande liée au désenfumage. Construisez une matrice simple : fonction, impact d’une perte, délai acceptable, mode de secours, responsable et condition de retour à la normale.\n\nLa criticité doit être évaluée avec l’exploitation, la maintenance, la sécurité et les métiers utilisateurs. Un automaticien seul ne peut pas deviner le coût d’un arrêt de quai ou la durée admissible d’une dérive de température. À l’inverse, les équipes métier ont besoin de l’ingénierie pour distinguer une gêne, une perte de performance et un risque technique réel.\n\nDéfinir des objectifs mesurables.\n\nPour chaque fonction critique, précisez le service minimal attendu : maintien d’une consigne élargie, marche forcée limitée, bascule sur un équipement de secours, alarme locale ou ronde renforcée. Indiquez aussi combien de temps cette situation peut durer. Cette durée oriente l’alimentation secourue, la capacité de stockage des historiques et l’organisation d’astreinte.
Préserver l’autonomie des automatismes locaux
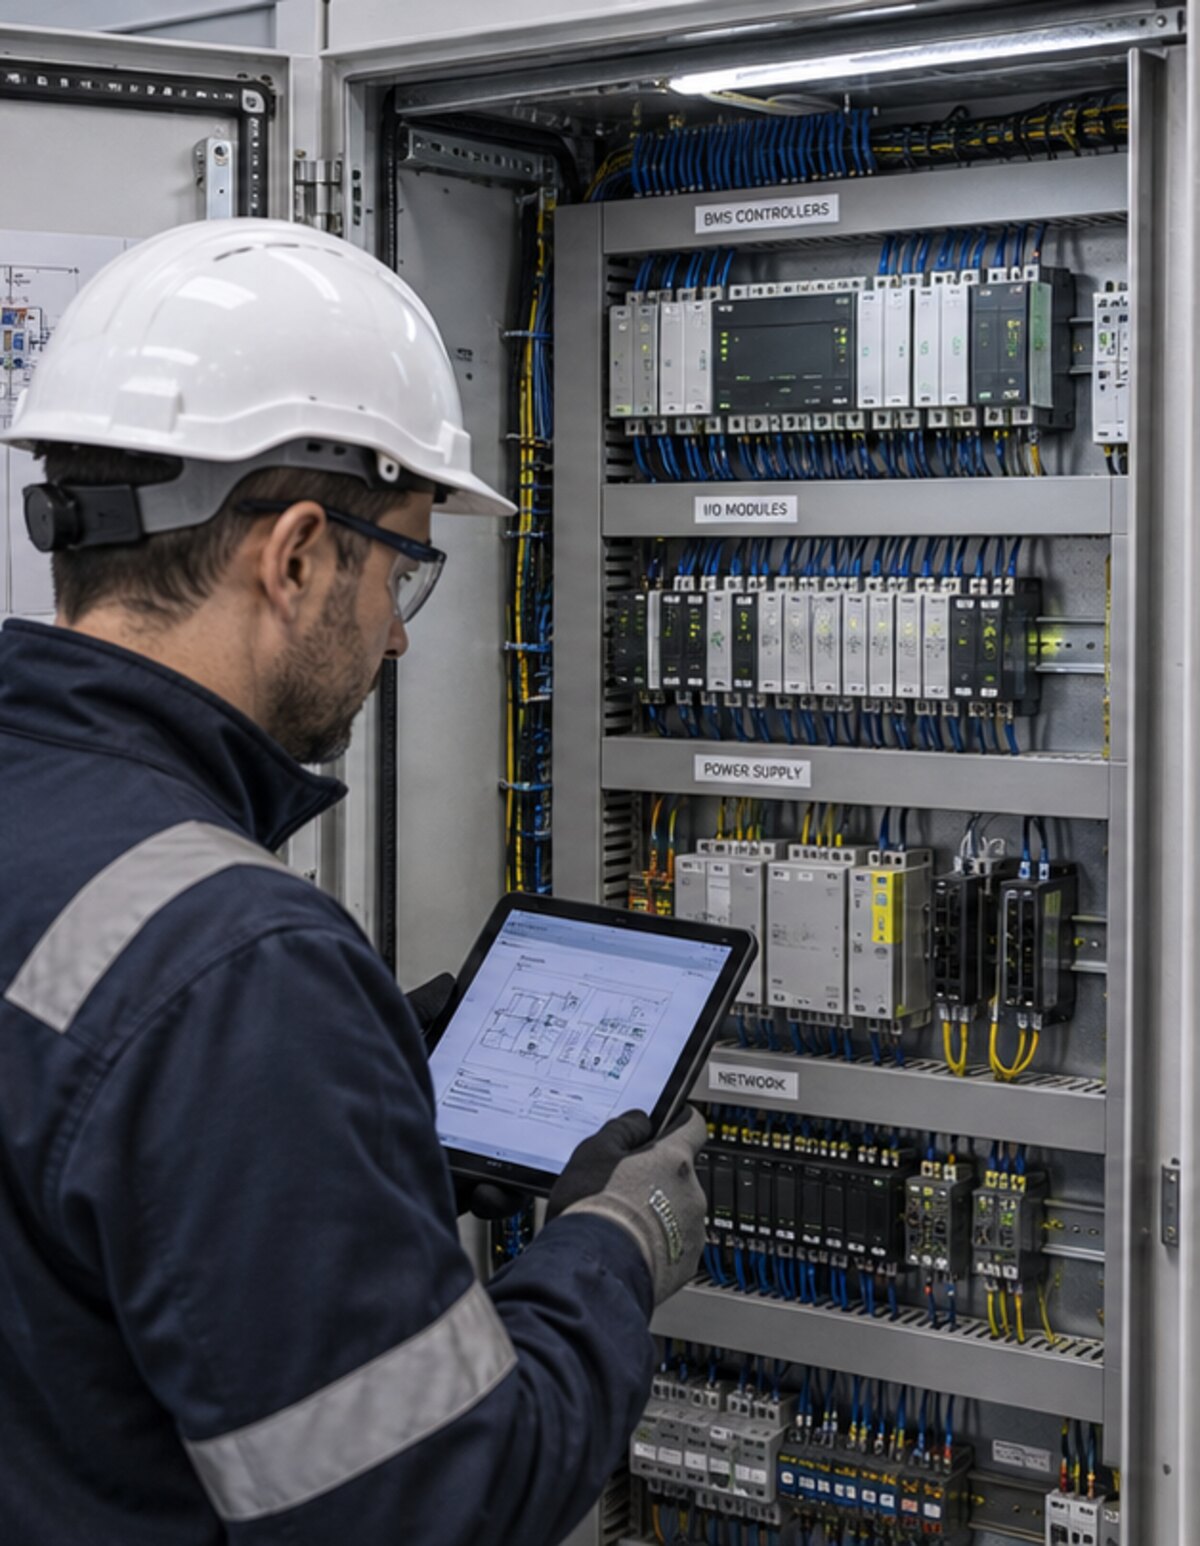
Une architecture robuste évite de dépendre en permanence du serveur central pour exécuter les boucles de régulation essentielles. Les automates doivent conserver leurs programmes, consignes de repli et calendriers indispensables en cas de perte de communication. La supervision facilite le pilotage ; elle ne devrait pas porter seule la logique vitale du procédé.\n\nVérifiez aussi le comportement à la remise sous tension : ordre de redémarrage, temporisations, limitation des appels de puissance, vérification des retours d’état et gestion des équipements qui ne redémarrent pas automatiquement. Une reprise simultanée de tous les groupes, pompes et centrales peut créer un nouvel incident alors que la panne initiale est terminée.
Définir des valeurs de repli cohérentes
Un capteur peut dériver, se figer ou devenir indisponible sans que la communication disparaisse. Le programme doit distinguer ces situations et appliquer une stratégie documentée. Selon le procédé, la valeur de repli peut être une consigne conservatrice, une dernière valeur valide limitée dans le temps, une redondance ou une bascule vers une commande locale.\n\nLes valeurs par défaut arbitraires sont dangereuses. Une température impossible ne doit pas provoquer une marche permanente sans limite, pas plus qu’un défaut de présence ne doit couper une ventilation indispensable. Chaque repli doit être analysé au regard de la sécurité, de l’énergie, du produit stocké et des contraintes de maintenance.
Maintenir une chaîne d’alarme utile
En situation dégradée, la quantité d’informations doit diminuer, pas exploser. Une perte réseau qui génère des centaines d’alarmes masque l’événement principal. Configurez une hiérarchie : cause racine, conséquences critiques et informations différées. L’exploitant doit savoir ce qui s’est passé, quelles fonctions sont encore disponibles et quelle action est attendue.\n\nPrévoyez plusieurs chemins quand l’enjeu le justifie : alarme locale, remontée indépendante, message vers l’astreinte ou relais sec. Toute voie alternative doit être testée. Un numéro obsolète, une passerelle jamais surveillée ou une alarme acquittée automatiquement donne une illusion de continuité.
Préparer des commandes manuelles sans contourner les sécurités
La commande manuelle est utile seulement si elle est accessible, identifiée et encadrée. Elle ne doit pas court-circuiter les sécurités matérielles ou réglementaires. Les sélecteurs local/arrêt/distant, interfaces de proximité et procédures de forçage doivent être cohérents avec les droits des opérateurs et la consignation.\n\nDocumentez pour chaque commande : condition d’autorisation, durée maximale, contrôle à effectuer et retour en automatique. Signalez visiblement les forçages actifs dans la supervision. Après l’incident, un équipement oublié en manuel peut dégrader la performance énergétique pendant des semaines.
Sauvegarder ce qui permet réellement de reconstruire
Une sauvegarde du serveur ne suffit pas. Il faut conserver les programmes automates, paramètres des variateurs et régulateurs, bases de points, synoptiques, certificats, configurations réseau, licences, versions logicielles et documentation d’architecture. Ces éléments doivent être datés, vérifiés et accessibles aux personnes autorisées même lorsque l’environnement principal est indisponible.\n\nLa restauration doit être testée sur une plateforme maîtrisée ou dans une fenêtre de maintenance. Mesurez le temps nécessaire, identifiez les dépendances et conservez une procédure pas à pas. Une sauvegarde jamais restaurée n’est qu’une hypothèse. Les principes de résilience et de défense en profondeur recommandés pour les systèmes industriels s’appliquent directement aux environnements GTB connectés.
Organiser la réponse humaine
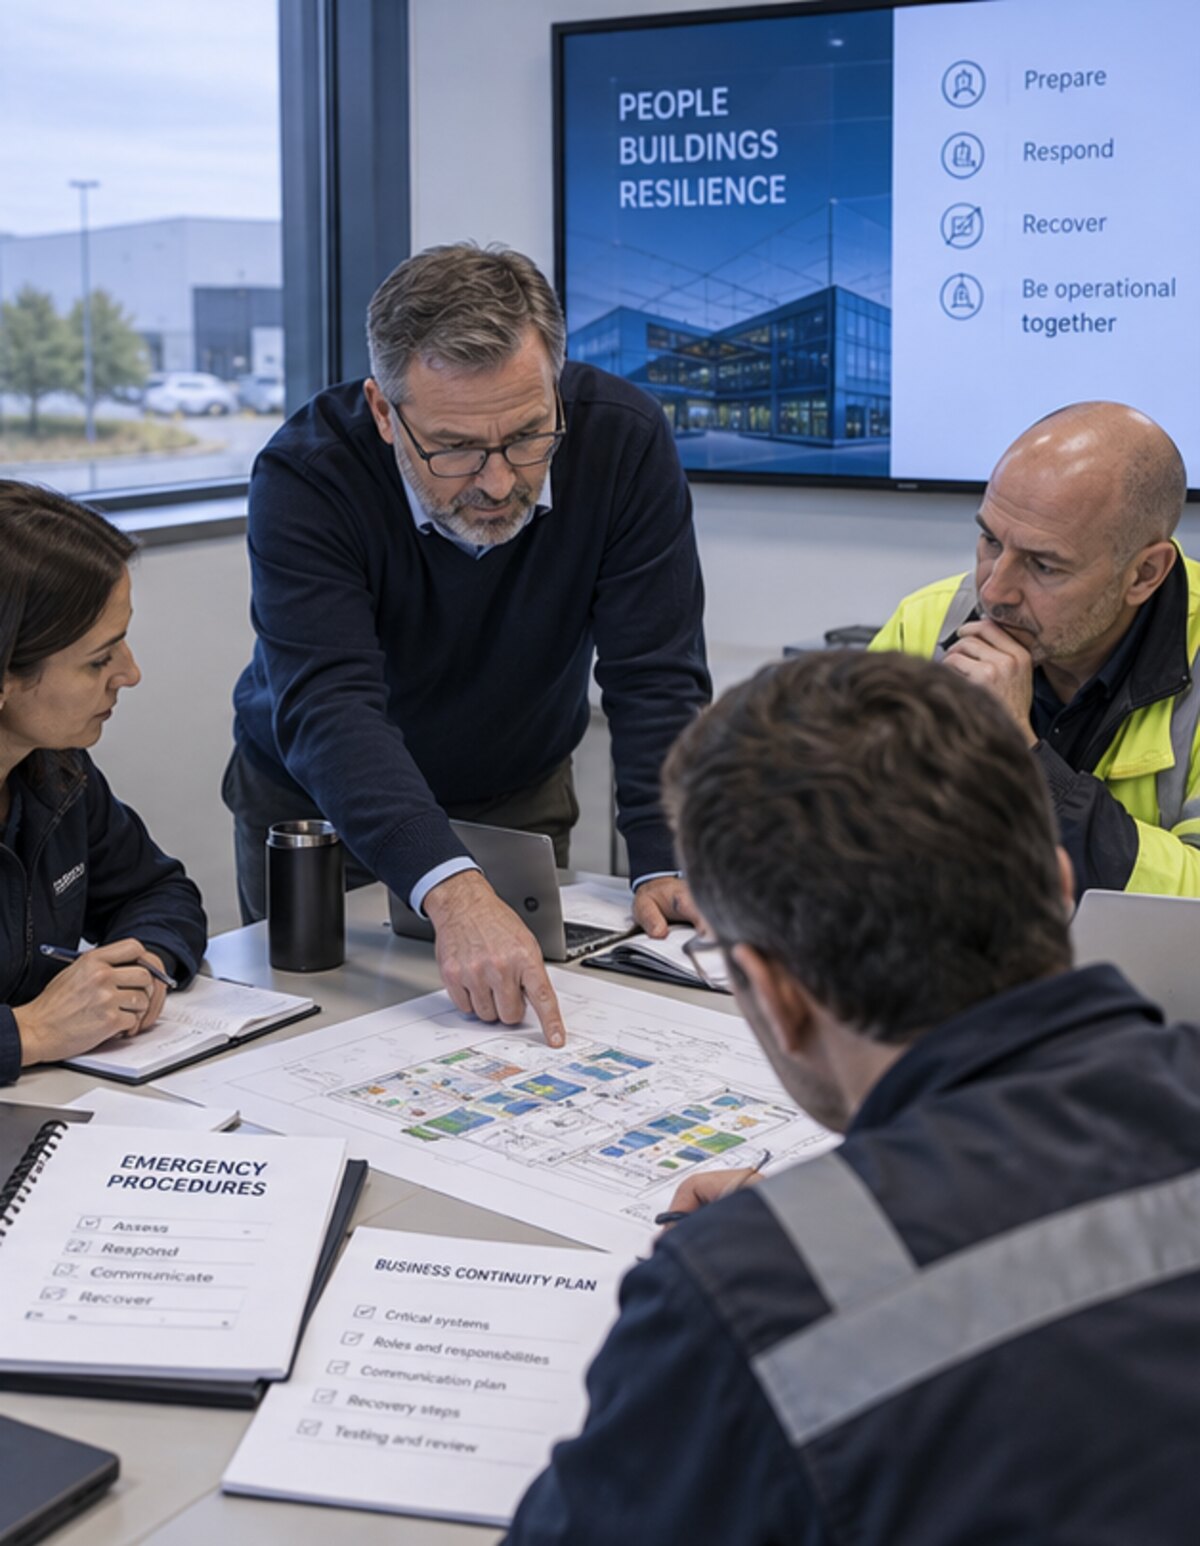
Le meilleur scénario automatique échoue si les responsabilités sont floues. La fiche réflexe doit tenir sur quelques pages : symptôme, diagnostic initial, fonctions maintenues, actions interdites, contacts, critères d’escalade et décision de retour. Elle doit être disponible hors de la GTB, par exemple dans une documentation contrôlée accessible à l’astreinte.\n\nFormez les équipes de jour et de nuit. Les agents doivent reconnaître un fonctionnement dégradé, distinguer perte de supervision et perte de régulation, effectuer les contrôles de terrain et transmettre des informations utiles. L’exercice sur table, puis l’essai technique, révèlent les dépendances oubliées : compte indisponible, mot de passe expiré, plan non à jour ou pièce de rechange introuvable.
Tester par scénarios, pas uniquement par composants
Un test de communication BACnet ou Modbus ne démontre pas la continuité du service. Organisez des scénarios réalistes : arrêt du serveur, coupure d’un commutateur, perte d’un automate, défaut de sonde, absence d’un fournisseur ou redémarrage après coupure électrique. Pour chacun, observez le comportement, les alarmes, la réaction des équipes et le retour à la normale.\n\nLes essais doivent être préparés pour ne pas créer un risque sur la production. Définissez le périmètre, les conditions d’arrêt, les personnes présentes et les mesures de sauvegarde. Tracez les résultats et corrigez les écarts. Le commissioning ne se termine pas à la réception : les scénarios doivent être rejoués après une évolution importante, une migration ou un changement d’exploitant.
Faire du retour à la normale une phase à part entière
Le retour automatique immédiat n’est pas toujours souhaitable. Avant de réactiver les optimisations, vérifiez les capteurs, les états des équipements, les forçages et la cohérence horaire. Certaines installations nécessitent une reprise par séquence et une validation manuelle. L’historique de l’incident doit être conservé pour comprendre la cause et mesurer la durée réelle de dégradation.\n\nAprès chaque événement ou exercice, conduisez un retour d’expérience court : ce qui a fonctionné, ce qui a ralenti, les documents manquants, les changements à programmer et le responsable de chaque action. La continuité d’exploitation devient alors un processus d’amélioration, pas un document rangé dans un dossier.